対象と根拠
- 情報確認日
- 対象クラウド
- AWS / Azure / GCP
- 提供状態
- 機能ごとに異なる
- 演習の実施状況
- 演習は未実施
条件・制約
- AWSとAzureのLakebase GAを別々に確認。開いたGCP概要はBetaで、対応regionはus-east4、us-central1、europe-west3。
- 設定はAWSのproject型Lakebase資料を使用。旧provisioned instanceと各cloudの機能提供は、それぞれ別途確認が必要。
- AWSのLTAP Direct WritesはPostgres 16/17/18の新規synced tableでGA。Lakebase CDFはPublic Preview。アカウントへの反映と実環境regionは未検証。
- 設計、演習、復旧計画は未実施。遅延、処理量、費用、failoverの測定結果はない。
推奨スコアと返金予約では、正本の持ち主が違う
架空の返品アプリを考える。AIエージェントが注文の返品リスクを表示し、サポート担当者が返金を予約する。昨日の分析モデルは「要確認」と判断していてもよい。しかし予約では、二人の担当者が同じ返金を同時に承認することを防がなければならない。予測の新しさと業務更新の正しさは、それぞれ別の問いである。
Lakebaseの概要は、Databricksに統合されたmanaged Postgresを説明している。本章ではこのトランザクションの役割を返金予約に使い、lakehouseの派生データを判断材料として読む。前提は、行の粒度、主キー、Delta table、および前章までのプラットフォームの役割分担。机上演習にはアカウントを必要としない。project作成、同期実行、failover試験は今後の作業であり、本章では実施していない。
図を横にスクロールして読む。
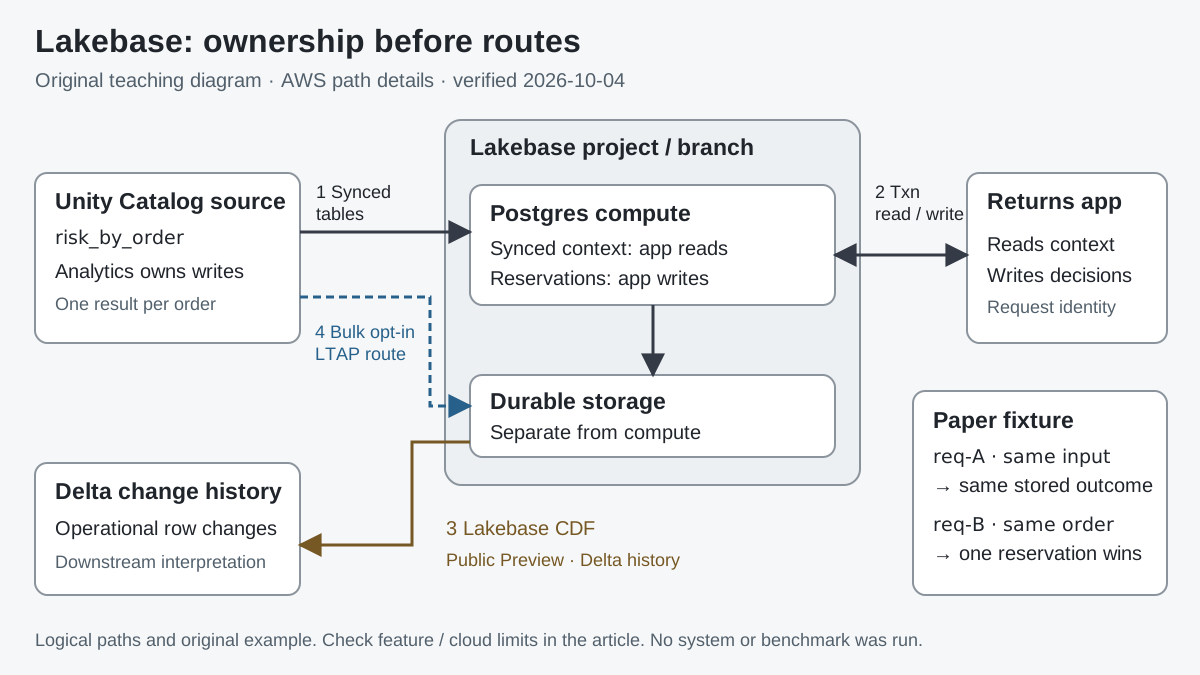
学習用に自作した概念図。製品画面、測定済み構成、提供範囲の保証ではない。図の番号に沿って経路を説明し、利用可能な範囲は以下のcloud・機能表で確認する。
手順を読む前に、世代・cloud・個別機能を確認する
「Lakebaseは使える」という一文だけでは設計審査に足りない。2026年10月4日に次の範囲を公式資料で確認した。
| 対象 | 確認した状態 | 設計上の境界 |
|---|---|---|
| AWSのproject型Lakebase | 2026年1月22日付のGA項目 | 現行のproject / branch / endpoint資料を使う。旧provisioned instanceとは契約が異なる。 |
| AzureのLakebase | 2026年3月2日付のGA項目 | Azureの公開はAWSとは別に確認する。 |
| GCPのLakebase | 概要は6月15日からBetaと記載 | 開いたproject資料のregionはus-east4、us-central1、europe-west3。projectはworkspaceのregionを使う。 |
| AWSのLakebase Search | 2026年9月18日付のGA項目 | 検索は独立した機能。本演習で拡張を有効化したり検索順位を評価したりはしない。 |
| AWSのLTAP Direct Writes | 2026年10月1日付のGA項目 | Postgres 16 / 17 / 18。synced tableの作成時に選択する。 |
| AWSのLakebase CDF | 現行資料はPublic Preview | 明示的なpreview有効化と宛先の条件がある。 |
日付付きの項目はAWS release notesとAzure release notesで確認した。GCPの状態とregionはGCP概要とproject管理資料、CDFの範囲は機能資料による。公開は段階的に反映される場合がある。これらの文書だけで、特定アカウントに機能が届いたとは判断できない。AWSの個別機能の状態をGCPにも適用しない。
世代の変化として重要なのは、AWSのproject型が2025年10月のBeta、12月のPublic Previewを経て2026年にGAとなったことだ。直近1か月の確認範囲は2026年9月4日〜10月4日、Asia/Tokyoの暦日。Search GAとDirect Writes GAがこの範囲に入る。日付付きの項目はその変更を裏付けるが、文書全体の初出日を裏付けるものではない。不明な出典公開日はunknownのまま保持し、10月4日より後の項目をリリース済みとして扱わない。
補助教材としてIntroduction to Lakebase: OLTP for Data Apps and AI Agentsを参照できる。**Databricks(@Databricks)**が2025年12月23日に公開し、公式製品ページからもリンクされている。全体像の把握に使い、本章の2026年の設定・提供状態は現行機能資料で確認する。動画は作者を明示したリンクとして参照し、画像を転載していない。
四つの経路を、四つの意味で読む
経路1:分析結果を配信する。 Unity Catalogのanalytics.returns.risk_by_orderなどをsynced tableの入力にする。同期資料はLakebaseに管理されたコピーを作り、その宛先を読む使い方を推奨している。Snapshotは全体を再取得し、Triggered / Continuousは初回ロード後に変更を取り込む。許容するデータの古さとsourceの対応機能からmodeを選ぶ。
本章のrisk_by_orderは注文ごとに一行で、model_versionとcomputed_atを持つ。アプリは「9時に計算されたスコア」と表示できる。DBへの問い合わせが成功したことを、モデル判断が現在の状態を反映している証拠にはしない。書き手は分析pipelineのまま。担当者の決定は別のテーブルへ書く。
経路2:業務状態をcommitする。 refund_reservationsはアプリが管理するPostgresデータである。どのrequestがどの返金を予約し、誰が判断し、予約が解除されたかを答える。配信されたリスクは判断材料だが、予約の正本ではない。分析jobが推奨を更新しても、過去の業務判断を上書きしない構成になる。
経路3:変更を下流へ公開する。 Lakebase CDFはPostgresの変更をUnity Catalog管理のDelta履歴へ出力する。対応する宛先catalog、権限、source tableのREPLICA IDENTITY FULLが必要で、default storageの宛先は使えない。アプリは予約を先にcommitし、下流のBIモデルが変更を別途解釈する。行の変更履歴は予約commandでも、完成した業務指標でもない。
経路4:一括ロードがstorageへ届く経路を変える。 LTAPは複数の個別機能を通じて提供されるarchitectureである。Direct Writesが変えるのはbulk loadの経路であり、データの持ち主ではない。同期資料では、全modeの初回ロードとSnapshotの全体再取得が対象。後続のTriggered / Continuousの増分は変更フィードの経路を使う。既存synced tableに後から有効化できないため、導入には移行計画が必要になる。本演習でテーブルを削除する作業はない。
権限も経路に結び付けて考える。LTAP資料は分析アクセスのUnity Catalog管理と、トランザクションアクセスのPostgres role / privilegeを分けている。Unity Catalogへのgrantが、アプリにPostgres予約の更新権限まで与えると仮定しない。identityごとに必要なread / writeを列挙し、両方の境界で検証する。
computeより先に、業務行の意味を決める
以下は本章独自の教材用テーブルであり、Databricksの製品schemaでも実装済みの例でもない。
| データ | 一行の意味 | 識別子と責任 |
|---|---|---|
risk_by_order |
注文ごとの現在の分析結果 | 分析側がorder_id、score、model version、計算時刻を管理する。 |
refund_reservations |
一つの返金requestとその現在の状態 | アプリが非nullのrequest_id、order_id、金額、通貨、state versionを管理する。 |
refund_decisions |
一つの記録済み業務遷移 | アプリがdecision_id、actor、理由、判断時刻、使用したscore / model versionを管理する。 |
| BI返金fact | 受理済み予約、または合意したevent粒度 | モデル担当者が集計対象の状態、訂正、通貨処理を定義する。 |
同じ注文に部分返金が複数回あってよいなら、order_idだけの一意制約は正当なrequestまで拒否する。全額返金を一度しか認めない業務なら、任意の異なるrequest_idを受け入れ、注文単位の規則を設けない構成では重複する。適切なキーは業務の不変条件から決まる。indexを作りやすい列から選ぶものではない。
本演習の規則は、注文ごとに全額返金予約は一つ、呼び出しrequestごとに永続的な結果は一つとする。同じrequestを金額だけ変えて再送したら、同一識別子の矛盾した再利用として拒否する。非nullのrequest key、保存した入力fingerprint、永続化した結果があれば、この規則を調べられる。PostgreSQLの制約資料はuniqueとprimary keyの性質を裏付ける。fingerprintと結果の扱いは本章独自のアプリ設計である。
アプリが先に確認し、後でinsertするだけでは同時実行の契約にならない。未実施の机上スケジュールで、担当者AとBがともに「未予約」を読む。Aが予約し、Bが古い観測を使って書こうとする。重なった操作のどこで不変条件を守るかを決める必要がある。対象があらかじめ決まった単純な一行なら、条件付き状態遷移や短いtransactionでの行lockを検討する。複数行にまたがる規則なら、適切なisolationとretry方針を検討する。PostgreSQL 17のisolation資料はRead Committedのstatement単位のsnapshotと、serialization failure後のtransaction全体のretryを説明している。強いisolationを選んでもretryの設計は必要である。
予約と判断の証拠は一緒に記録する。外部の決済処理は独自のidempotency契約を持つ別の操作として扱う。DB transactionだけで、外部返金が一度だけ実行されたとは証明できない。commit後の応答が失われたら、同じrequestには保存済みの結果を返す。決済を無条件で繰り返すと、復旧可能な接続エラーが業務上の二重払いになる。
設定値が変えるのは容量と失敗時の振る舞い
次の値は10月4日に読んだAWSのproject型資料の条件であり、本番推奨値ではない。
| 設定 | 確認した効果・制限 | この設計で答える問い |
|---|---|---|
| minimum / maximum CU | autoscalingは64 CUまで、maximum − minimum ≤ 16 CU |
最小値でworking setと最初のburstを扱えるか。最大値を超えた負荷はどう扱うか。 |
| scale-to-zero | maximumは32 CU以下。timeoutは60秒〜7日、defaultは24時間 | clientは再起動を待ち、session状態を再構築できるか。 |
| high availability | primary一つとsecondary 1〜3。scale-to-zeroは使えない | この業務に、常時確保するfailover容量の費用を払う価値があるか。 |
| connection容量 | autoscalingではmaximum CUと8 × minimum CUの小さい方に依存。管理用接続は別に予約される |
アプリの全instanceと他の利用者を合計したpool予算はいくつか。 |
それぞれautoscaling、scale-to-zero、HA、compute管理で裏付けた。設定済みの範囲内での自動調整には再起動が不要でも、CU境界自体の変更は接続を中断する場合がある。computeの停止でsession contextは失われる。HAが保護するのは一つのregion内のcompute障害で、failover後には既存接続の再接続が必要になる。
独自の設定確認例として、2〜8 CUの差は6 CU。2〜32は30 CUの差となり、資料の範囲制約を超える。8〜40 CUは差の制約にも、scale-to-zeroのmaximum制約にも違反する。この算数で確認できるのは設定の適合性だけ。返金サービスの遅延やburst耐性は推定できない。
架空の構成で、六つのアプリinstanceがそれぞれ20接続のpoolを要求すると、client接続は120になる。migration toolや他の利用者はまだ含めていない。実際のendpoint上限を調べ、全体で一つの予算を決める。pool予算がないままweb tierを増やすと、DBへの圧力も増える。この値は計画用の仮定であり、Lakebaseには設定していない。
予約が遅くなったら、まずlock待ち、queryの処理、pool待ち、接続復旧を分ける。maximum CUを増やしても、矛盾する業務規則は直らない。idle timeoutを短くすると、断続的なアクセスで再起動が増えることもある。仮説を一つずつ変え、その層の証拠を記録する。
準備の順序、代替案、費用の台帳
今後sandboxを用意するなら、最初にworkspaceのcloud、region、世代を確定する。提供範囲と認可済みの費用を確認してから、隔離したproject / branch / databaseを作る。アプリroleと同期identityを分け、source schemaと変更取得条件を整え、配信キーとmodeを選び、配信テーブルを作る。その後、承認された認証方式で正しいbranch endpointへ接続する。compute資料ではAPI resource nameと接続hostnameを区別するため、表示名からhostnameを推測しない。本章に資格情報や接続文字列は含めていない。
まずworkloadを書き出し、実際の代替を比較する。
| 用途 | 候補 | 評価するtradeoff |
|---|---|---|
| 大きな履歴scan、aggregate、BI report | 既存の分析tableとSQL compute | 分析モデルを中心に保てるが、それだけで返金transactionを実装するものではない。 |
| 派生データを読むアプリと業務状態の更新 | Lakebaseの配信tableと別の業務table | 判断材料と決定を近くに置ける。同期の鮮度、Postgres権限、運用容量の判断が増える。 |
| 既存の業務DBが要件を満たす | DBを維持して必要な分析連携を設計 | 不要な移行を避けられる。連携の責任とデータ重複の扱いを比較する。 |
| 古さを許容できる反復read | 用途が許せばアプリcache | DB readを減らせる場合があるが、競合する返金writeの正本にはできない。 |
これは設計候補であり、測定に基づく順位ではない。新しいサービスを採用する前に、現在のDBと明確なデータ契約で解ける問題かを確かめる。
費用の台帳には、branch・replicaごとの稼働compute、データとindex、backup / history / snapshotの保持、同期処理、対象となる転送・接続料金を並べる。項目によって請求元が別のDatabricks機能やcloudに分かれる場合があるため、選択した構成のmeterを確認する。Lakebase料金ページも、価格表示とregionでの提供を区別している。AWS release履歴ではsnapshot storageの課金開始が2026年6月1日とされる。computeが止まっても、保持中の全resourceが無料になるわけではない。本章では価格見積もりも費用比較も計算していない。
失敗が見える机上fixture
紙の上で二つの注文と、次の架空requestを用意する。分析スコアの計算時刻、DB commit時刻、下流が観測した時刻を別の列にする。
| 入力 | 本演習の業務上の期待 | 残す証拠 |
|---|---|---|
req-A、注文10、金額60、初回 |
予約は一つ | request identity、合意したpayload、commit済み状態、判断記録 |
同じpayloadのreq-Aで応答消失後にretry |
保存済みの同じ結果 | 二つ目の予約や外部決済がないこと |
req-Aの金額を80へ変更 |
conflict | 元のrequestに紐付くpayload不一致の拒否 |
注文10のreq-Bがreq-Aと重なる |
全額返金予約の成功は一つだけ | 注文単位の不変条件と、負けたrequestの定義済み結果 |
| 注文20の予約後にscoreが更新される | 過去の判断を追跡できる | 判断時に使ったscore / model versionと現在のscoreの区別 |
このfixtureは未実施。重なるrequestのどちらが先に成功しても、結果を追ってみる。次にcommit後のclient応答を消し、古いscoreを挿入し、下流の変更処理を遅らせる。各componentがどの状態を知っており、画面にどの説明を出せるかを考える。「同期は正常」は返金済みの証拠ではなく、「アプリはretryした」は予約が二重になった証拠でもない。
今後、認可された隔離環境で検証するなら、cloud、region、Postgres version、機能状態、schema、role grant、pool上限、CU境界、同期設定を固定する。requestの重複、payload競合、二人の同時予約、再接続、下流遅延を試す。request遅延のp50 / p95 / p99、lock待ち、pool待ち、sourceから配信までのデータ年齢、CDC backlog、実際の課金meterを観測する。再接続後に保存結果を確認し、read-only identityの権限失敗も調べる。HAや障害注入には別途範囲を限定した試験計画が必要で、いずれも未実施である。
判断の軸は、誰が何を書くかという地図になる。分析が推奨を作り、アプリが予約をcommitし、下流モデルがcommit済みの履歴を説明する。computeと同期の設定はそれぞれの経路を調整する。業務上の正本を選ぶのは、先に定義した契約である。
出典
公開日は資料の日付、確認日は内容を参照した日です。コミュニティの観測は公式の確定事項と区別します。
01