対象と根拠
- 情報確認日
- 対象クラウド
- AWS
- 提供状態
- 機能ごとに異なる
- 演習の実施状況
- 演習は未実施
条件・制約
- 実装の参照はAWSの公式資料。Azure/GCPの同等機能、アカウントでの有効化、実際の配信regionは未検証。
- Lakewatchは2026年3月24日にPrivate Previewとして発表。現行GAと正確なregion別提供は未確認。
- Managed agent memory/sessionsとAgent Bricks CLIにはBetaの境界がある。発表は個別アカウントへの展開を証明しない。
一つの依頼から、責務の境界を描く
「この顧客にはなぜ請求書が二つ届いたのか。返金してよいのか」。サポート担当からのこの依頼を考える。これは独自の設計演習であり、実際の顧客システムや測定結果ではない。答えるには、信頼できる業務データ、根拠を伴う説明、返金を行う権限、取引の永続的な状態、誰が行ったかの記録が必要になる。モデルのendpointを用意するだけでは、このうち一つしか解決しない。
分析履歴、取引状態、AIの推論とツール、セキュリティ調査の四つに責務を分け、identityとgovernanceをそれぞれに重ねる。同じ顧客を指すtable、agentのmemory、security alertでも、読者、保持期間、変更できる操作は違う。共通のplatformを使うことは、一つのtransactionや一つのpermission boundaryであることを意味しない。
図を横にスクロールして読む。
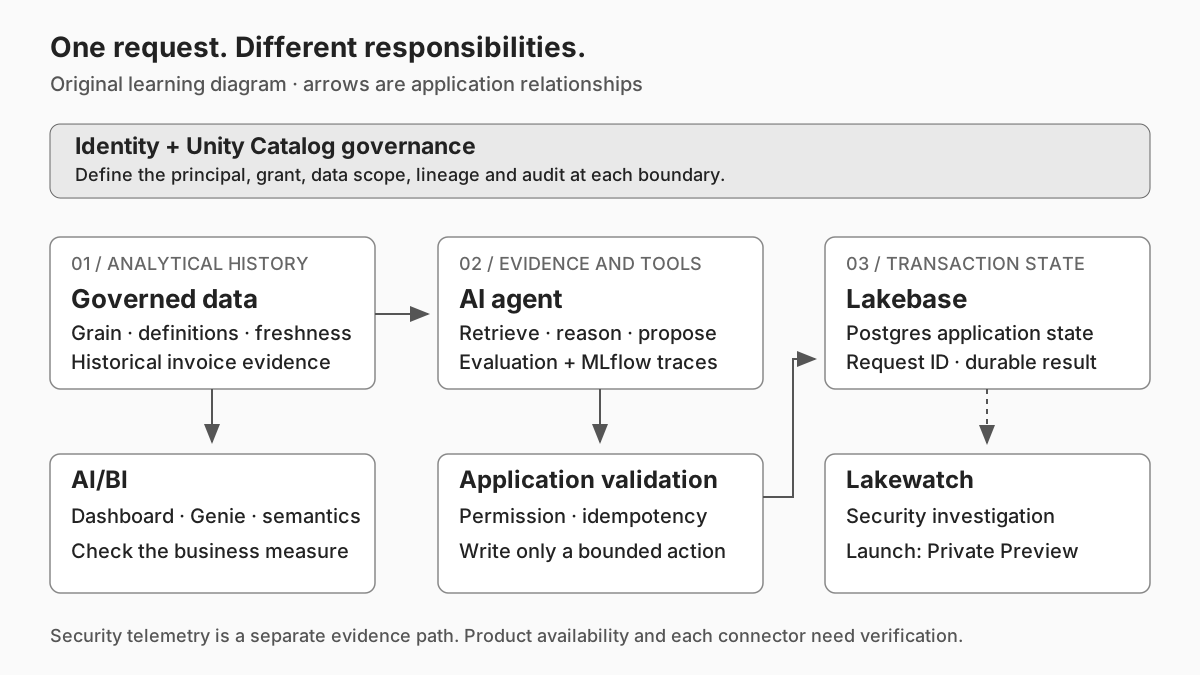
Databricksの製品図、画面写真、測定結果の転載ではなく、この教材のための自作図である。図を元のサイズで開く。矢印はアプリ設計上の関係を表し、すべての組み合わせにnative connectorがあると保証するものではない。図のAnalytical historyは分析履歴、Transaction stateは取引状態、Evidence and toolsは根拠とツール、Security investigationはセキュリティ調査に相当する。
各サービスに、担当する仕事を一つずつ与える
| 責務 | 提供するもの | アプリ側で決めること |
|---|---|---|
| 統制された分析データ | レポートや検索に使う過去の根拠 | レコードの粒度、業務定義、鮮度、機微なcolumn |
| Unity Catalog | assetの発見、grant、lineage、audit | 各操作を実行するidentityと権限の付与手順 |
| AIサービスとagent tools | 根拠を踏まえた推論、選択したtoolの呼び出し | 許可する操作、評価基準、確認、冪等性 |
| Lakebase | アプリの取引やagent状態を保持するPostgres | schema、transaction境界、分離、接続、保持期間 |
| AI/BI | dashboard、対話分析、再利用できる意味定義 | 正本となる指標と回答の確かめ方 |
| Lakewatch | telemetry、検知、security investigation | 有効化条件、応答の権限、incident対応の手順 |
Unity Catalogの公式資料は、多くのsecurable assetをcatalog/schema/objectの階層で扱う。Managed assetとexternal assetではstorage lifecycleの責任も異なる。統制されたobjectの名前は、単なるfolder名ではない。演習では請求の分析table、それを読むfunction、functionを動かすprincipalを別々に書き、各辺で必要な権限を列挙する。
Agentの資料では、modelへのアクセス、作成、tool、配備、評価が分かれている。MLflow tracingはagentがたどった手順を、評価は品質、費用、latencyを調べる助けになる。流暢な回答もtraceの存在も、返金の許可を証明しない。書き込み操作は、request ID、決定的なvalidation、記録する結果を持つ、範囲を絞ったアプリのfunctionとして設計する。
Assistantを加える前に、データの粒度を決める
一件のrecordが何を意味するかを選ぶ。演習では請求明細と請求書は別物であり、支払い試行と決済完了も別物、顧客と契約accountも別物である。customer → invoice → invoice_lineとinvoice → payment_attemptを別の関係として描く。返金が請求書、支払い、明細のどれに結びつくかを決める。「重複」を何と定義するかを決めてから、modelに説明を求める。
- 1元のevent
- 2請求の粒度を検証
- 3共通の業務指標
- 4BIの回答
- 1質問
- 2権限を持つ根拠tool
- 3操作の提案
- 4アプリの検証
- 5取引の記録
顧客二人、請求書三枚、支払い試行四回の小さな紙上fixtureを作る。支払いの再試行、遅れて届くevent、顧客参照の欠損を含め、未払い額の期待値を手で計算する。二つのtoolが「支払い済み」を違う意味で使うなら、先に定義を直す。AI/BI資料はdashboard、Genie Agents、Unity Catalog semanticsを関係する要素として説明している。ここで作るfixtureは、それらの存在だけでは得られない業務上の受け入れ基準である。
Lakebaseは取引状態と分析用途をつなぐ
Lakebaseの概要は、managed Postgres、synced tableによるlakehouse dataの配信、Postgres変更をDeltaへ保存する経路を説明する。確認した概要では最後の経路にPublic Previewと明記されている。矢印の方向ごとに、鮮度の契約を書く。任意のPostgres writeが、すべての分析tableに即座に反映されるとは考えない。
演習ではcredit_request(request_id, customer_id, status)を操作上の状態として保持し、返金の分析履歴は別のdata productとする。通信が途切れた後の提案は、成功、拒否、未確定のいずれもあり得る。再試行時に新たな返金を作らず、request IDで状態を確認する手順を指定する。以下はアプリの設計判断であり、table内のすべてがLakebaseの組み込み設定ではない。
| 選択・設定 | 設計への影響 | 比較するトレードオフ |
|---|---|---|
| Autoscalingの最小・最大CU | 稼働中のcompute容量を制限する | 最小が小さいとworking setを圧迫し、最大が大きいとcompute支出が広がる |
| Scale-to-zero timeout | 無操作時間の後に停止する | Idle時の節約と、再起動・session contextの再作成が増える可能性 |
| 開発用branch | Schema実験を分離する | 親branchの後の変更を継続購読するものではない |
| 分析tableのsync配信 | アプリ向けの配信経路を作る | Syncedを同期的と考えず、replicationの鮮度を観測する |
| アプリのrequest ID | 一回の意図した変更を識別する | Unique制約とretryの契約を自分で設計する必要 |
確認したAWSのautoscaling資料では、最小・最大の差は16 CU以内、scale-to-zeroを使える最大サイズは32 CU以下とされる。HAとの併用には追加条件があり、scale to zeroは使えない。これは現在のAWS参照条件であり、全cloudの保証ではない。紙上で2–8 CUを選ぶと範囲には収まるが、必要な容量や価格を確定したことにはならない。
Scale-to-zeroの参照資料は、60秒から7日までの無操作timeoutと、停止後にsession contextがresetされることを説明する。社内support appが夜間使われないと仮定し、短いtimeoutと稼働を維持する場合を比べる。Cold requestが何を初期化し直すかを列挙する。Productionのtimeoutを決める前に、認可された環境で初回requestのlatencyと接続errorを測る。この演習では測定していない。
Project資料では、子branchは作成時の親のdataを継承し、その後の親の変更は自動伝播しない。請求schemaの変更を開発branchで試すことと、配備・data migrationを設計することは別である。Branchを作っても、productionの顧客dataをより広い開発groupへ公開してよい理由にはならない。
外部接続は、今queryするか、先に取り込むか
Federation資料は、外部databaseのcomputeを使うread-only query federationと、Databricks computeでobject storageへアクセスするcatalog federationを区別する。Writeや実行の細かな制御が必要なSpark data sourceとも別の選択である。
請求調査で外部billing systemへ時々read-only queryする用途にはfederationが合うかもしれない。繰り返し履歴を分析する用途では、明示した鮮度目標を持つingestionを選ぶ理由がある。外部DBの負荷、転送とcompute費用、credentialの所有者、schema drift、障害の診断を比べる。「コピーしない」は一つの移動経路を減らすが、外部DBの可用性への依存を消さない。Remote境界でtimeoutした場合を図に加え、assistantが残高を作り上げず「根拠を取得できない」と返す基準を決める。
Lakewatchには、security製品としての有効化境界がある
2026年3月24日の発表は、Lakewatchをsecurity、IT、business dataを結びつけるagentic SIEMと説明し、発表時にPrivate Previewと明記している。ここではこの日付付きの状態を根拠として保持する。現行GA、regional endpoint、account entitlement、実際の応答は未確認であり、marketing上の説明は検証済みのavailability matrixではない。
演習ではsecurity telemetryを独立した調査経路に置く。Model traceは回答を、audit eventはアクセスを、detectionはsecurity hypothesisを説明する。調査でこれらをjoinすることはあるが、答える問いは異なる。拒否されたdata readが続いた後にtool invocationがあった場合、caseを開くべきか考える。最初の演習はread-onlyにし、signal、期待する根拠、reviewerの判断を指定するだけで、containment操作を接続しない。
新機能は、設計判断を変える根拠として読む
確認した9月のrelease pageは、managed agent memory/sessionsを9月16日、Agent Bricks CLIを9月29日のBetaとして記録している。10月のpageは、compute version条件を伴うJDBC Unity Catalog connectionsのGAを10月2日とし、OAuth M2MはBetaのままとする。Integrationの選択を変える情報だが、このaccountへ段階配信が届いた証明ではない。10月5日付のgroup-run pipeline項目は10月4日の確認時点で未来なので、release済み機能から除外する。
5月7日のBrahmareddyによるcommunity記事は、アプリと分析を同じplatformで扱うことへの期待を述べる。個人の経験談であり、製品の契約やこの教材の測定ではない。広い「sync不要」という表現で、公式概要が明示するsyncやchange feedの経路を置き換えない。どの経路、鮮度、製品世代を観測した話なのか、という問いを立てる材料として読む。
演習:一つの設計を説明し、反例に耐える
これは未実施のoffline演習である。一枚の紙に請求の根拠、返金transaction、security investigationの三経路を描く。各矢印にinput、output、identity、failure stateを付ける。Tableの粒度、request ID、配信の鮮度目標、scale-to-zeroの仮定を一つずつ選ぶ。費用は架空の価格を作らず、何に課金が発生するかを書き出す。
次に三つの反例を紙上で試す。外部sourceがtimeoutする、返金提案が繰り返される、agentは請求を読めるが変更できない。利用者に何を表示するか、どのrecordが結果を証明するかを決める。従来の外部Postgresを維持する条件、federationよりingestionを選ぶ条件も説明する。Auto Loaderの設計と統制されたagent dataのケースへ進む。資格試験の練習はDatabricks学習の入口から別の導線で開く。試験の点数は、この設計を検証した結果ではない。
出典
公開日は資料の日付、確認日は内容を参照した日です。コミュニティの観測は公式の確定事項と区別します。
01