対象と根拠
- 情報確認日
- 対象クラウド
- AWS / Azure / GCP
- 提供状態
- 機能ごとに異なる
- 演習の実施状況
- 演習は未実施
条件・制約
- AWS 版公式資料を確認。Azure/GCP は概念上の入力対象であり、個別 workspace・region の提供状況を検証していない。
- Runtime・compute・storage path・Unity Catalog 権限で設定条件が変わる。コード例は Preview の type widening に依存しない。
- コードと演習は未実施。Databricks 上の性能・費用・復旧を測定していない。
ファイルは一度届いた。注文は二度集計された
注文を出力するシステムが part-001.json をアップロードし、翌日の再送では retry-001.json に同じ注文イベントを書いたとする。ダッシュボードが両方の行を足せば、取り込みジョブが成功していても売上は誤る。これは説明用の架空例であり、Databricks で観測した障害ではない。
Auto Loader は Structured Streaming の入力 cloudFiles を提供し、オブジェクトファイルを増分で発見して読み、進捗を checkpoint に保存する。これで「この取り込みストリームが、どのファイルを処理したか」を扱える。注文イベントをどう識別するか、修正注文をどう解釈するか、ダッシュボードが何を集計するかには、さらに判断が必要になる。
頭に置くのは オブジェクト → 発見済みファイル → 解析した行 → 検証したイベント → 業務指標 という契約の連鎖である。ある矢印が成功していても、その先は誤りうる。パーサーが "amount": "19.95" を受け取っただけでは、通貨も税込かどうかも、後から届いたファイルがその取引を取り消すのかも確定しない。
図を横にスクロールして読む。
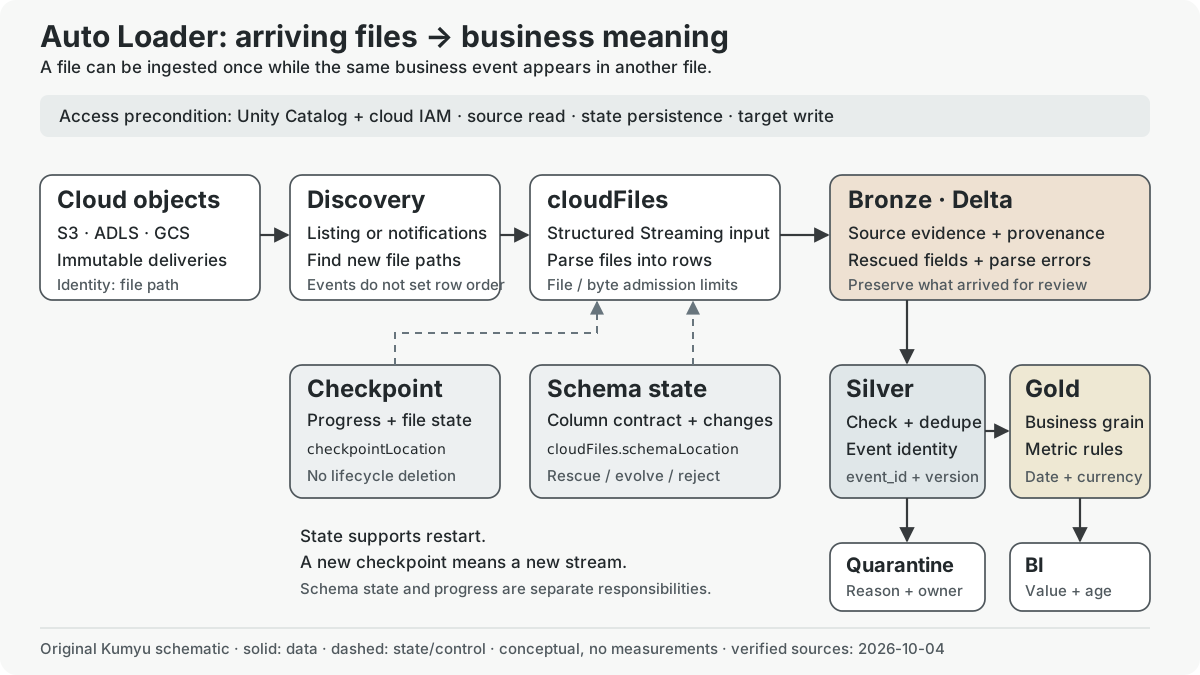
Kumyu 作成の説明図。実線はデータの移動、破線は制御や状態の関係を表す。箱は責務であり、独立したサーバーや測定した遅延を表していない。公式画像の転載ではない。
確認した範囲と、適用できる範囲
出典は 2026-10-04 に実際に開いた Databricks 公式ドキュメントの AWS 版である。入力一覧 は S3、ADLS、GCS、Unity Catalog volumes を挙げる。AWS 版の発見方式比較 には S3・ADLS・GCS の file events が Runtime 14.3 LTS 以上と記載されている。これは文書に書かれた条件であり、特定の AWS・Azure・GCP workspace、region、compute 構成で使えることを確かめた結果ではない。
| 境界 | この教材での意味 |
|---|---|
| Cloud | AWS 版資料を確認。Azure と GCP は概念上の入力対象であり、現在の region・workspace ごとの提供状況は個別に確認していない。 |
| Runtime と compute | 実際の Runtime、compute 種別、path、access mode を記録してから設定を適用する。コード例は適切な Unity Catalog 環境を前提とし、実測済みの互換表ではない。 |
| Preview | schema 資料は addNewColumnsWithTypeWidening を Runtime 16.4 以上の Public Preview と記載。コード例は rescue を使い、Preview を暗黙の前提にしない。 |
| 実施状態 | 設計、コード、復旧演習は Databricks で未実施。処理量、請求額、復旧時間、正確さは測定していない。 |
文書の改訂日と機能の公開日は異なる。schema と発見方式の資料には 2026-09-11、production guidance には 2026-09-18、options reference には 2026-09-23 の改訂表示がある。元の公開日は不明である。明示した調査窓 2026-09-04〜2026-10-04(Asia/Tokyo) には入るが、記載された全機能がその一か月で公開された証拠ではない。歴史として確認できる範囲も限定する。Runtime 14.3 LTS の release notes は 2024 年 2 月の公開を記し、当時の native XML support を Public Preview として説明している。当時の Preview を現在の提供状態に読み替えない。10 月 4 日より後の項目も、すでに公開された事実として扱わない。
混ぜない五つの名前
landing path には producer が作ったファイルが置かれる。配信ごとに一意な名前を持つ、変更しないオブジェクトを基本にする。discovery mode は新しい path の見つけ方を決める。cloudFiles はそのファイルを行に読む。cloudFiles.schemaLocation は推論した列の契約と変化を保存する。checkpointLocation はストリーミングクエリの進捗と状態を保存する。
schema guide は schema と checkpoint に同じディレクトリを使うことを許容し、Lakeflow pipelines ではそれらを管理できる。教材のコードは責務が見えるようにサブディレクトリを分けた。これは整理の判断である。どちらも出力先 Delta table の代わりにはならない。独立した入力の進捗台帳を共用せず、取り込み workload ごとに checkpoint を割り当てる。
架空の注文サービスで path に date=2026-10-04 があっても、それは producer がファイルを置いた場所を示すだけである。すべての注文が 10 月 4 日に発生した証拠にはならない。先月の注文の修正が今日届くこともある。ファイル到着時刻、イベント発生時刻、ダッシュボード更新時刻を別々のフィールドと方針で扱う必要がある。
Exactly once の境界
FAQ は通常のファイル識別を path で説明し、不変のファイルを推奨し、上書きに注意を促す。cloudFiles.allowOverwrites=true では更新ファイル全体が再処理されることがあり、業務レコードの繰り返しは pipeline 側で扱う必要がある。新しい checkpoint は実質的に新しいストリームを始める。ディレクトリ名の変更は、見た目の整理ではなく復旧の判断になる。
production guide は checkpoint のファイルを lifecycle policy で削除するとストリームの状態が壊れると警告する。cloudFiles.maxFileAge を過度に短くしても取り込みの欠落や繰り返しを招きうる。ファイル状態の追跡期間、入力ファイルの保存期間、Delta table の保存期間を分けて決める。それぞれが守る証拠は異なる。
part-001.json と retry-001.json に対しては、producer が発行した event_id を使う Silver の規則を作る。過去のイベントを修正できる producer なら、イベントの version または修正方針も決める。order_id だけで重複排除すると、その注文で後から発生した正当なイベントも消してしまう。逆にファイル名だけで排除すると、別名で再送された同じイベントが残る。これはデータモデルの判断であり、Auto Loader が path から推論することはできない。
ファイル処理の保証を、任意の副作用へ拡張しない。独自の batch handler がメールを送る、あるいは別の業務サービスへ書き込むなら、その操作の冪等性を別に設計して試す。Delta への取り込みが commit されたことは、外部のメールが一度だけ送られた証明にはならない。
設定値は処理の境界を変える
options reference は Auto Loader の cloudFiles.* と他の Spark source の設定を区別する。一般的な file source の例から maxFileAge をコピーすると危うい。似た名前でも、それぞれの文脈がある。
| 設定 | 公式に記載された影響 | 設計で考えること |
|---|---|---|
cloudFiles.maxFilesPerTrigger |
micro-batch の新規ファイル数を制限。reference の default は 1,000、Runtime 18.0 以上では動的に設定すると記載。 | 小さなファイルが大量に届く場合は個数が効く。行数や遅延目標を表す値ではない。手動調整前に Runtime を確認する。 |
cloudFiles.maxBytesPerTrigger |
byte 数の柔らかい境界。ファイルは分割されない。両方の制限がある場合は先に到達した方が処理対象を制約する。Runtime 18.0 以上ではこれも動的設定。 | 一つの大きなファイルが値を超えうる。メモリの厳密な上限にはならない。 |
cloudFiles.includeExistingFiles |
default は true。最初のストリーム初期化で評価され、再起動後に値を変えても再評価されない。 |
最初に開始する前に backfill を決める。既存ストリームを replay するための切り替えではない。 |
cloudFiles.schemaLocation / checkpointLocation |
それぞれ schema / ストリーミング進捗を永続化する。 | 消えない path と管理者を決める。一時ディレクトリは復旧の契約に向かない。 |
二つのサイズ制限は deprecated な Trigger.Once では効かない。AvailableNow は起動時点で利用可能な入力を複数の micro-batch に分けて処理し、終了できる。ストリーミング入力だからといって、compute を常時起動する必要があるわけではない。
紙上の計算として、decimal のサイズ表記を使い、手動設定が適用される互換環境を想定する。20 kB のファイルが 1,200 個なら合計は 24 MB なので、100 個の admission limit は 200 MB の値より先に効く。25 MB のファイルが 10 個なら byte の境界が先に効きうる。一つの 350 MB ファイルは、その全体を読まなければならない。この数字は粒度の説明であり、性能、正確な batch の詰め方、推奨本番設定を表していない。圧縮サイズ、解析後の表現、join、skew があるのでメモリは別途測定する。
毎時のレポートなら、到着窓ごとに入力を消化する job と、compute を起動し続ける方法の費用を比べる。業務アラートなら trigger interval だけでなく producer から consumer までの全遅延を評価する。production の費用説明 は compute と discovery を別の費用として扱う。起動、発見、解析、書き込み、下流の更新を別々に記録してから周期を選ぶ。
スキーマ方針は、中断と証拠の選択
exporter が coupon_code を追加した。Bronze を止めるのか、列を増やすのか、予想外の値を確認用に残すのか。schema evolution の公式説明 には次の選択がある。
| 方針 | 新しい列に対する動作 | 引き受ける負担 |
|---|---|---|
addNewColumns |
schema state を更新したあとストリームが失敗し、再起動で新 schema を使う。明示 schema がない場合のみ default。 | 再起動と出力先 schema の扱いを計画する。新しい入力列が、そのまま承認済み BI 列になるわけではない。 |
rescue |
schema を固定し、想定外のデータを rescued column に保存する。 | 取り込みを継続する代わりに、担当者のいる確認待ちキューが必要になる。 |
failOnNewColumns |
自動で schema を変えずに失敗する。 | producer の契約違反が、中断として表に出る。 |
none |
schema を進化させず、rescued column がなければ新しい列を無視する。明示 schema がある場合の default。 | rescue がなければ、取り込み成功と情報欠落が同時に成立しうる。 |
完全な明示 schema を渡した場合、addNewColumns は許可されない。schema hints は別である。default の JSON 推論は string を優先する。金額、timestamp、通貨への変換は、推論への期待ではなく意図的な検証工程で決める。Public Preview の widening mode は Runtime 条件を持つ追加の選択であり、すべての型変更を互換と見なす理由にはならない。
rescued column は schema に合わないフィールドを保持し、型や大文字・小文字の不一致も対象になる。JSON の構文が壊れたレコードは別の障害である。best-practice guide は _rescued_data と _corrupt_record を区別し、入力 metadata の記録を勧める。注文設計では、新しい coupon_code は schema の確認項目、不完全な JSON オブジェクトは parse error の確認項目になる。どちらも件数を数え、ファイルへ遡れ、必要な検査を通るまで認証した指標から外せることが必要である。
rescue は仕事を移す。仕事を消さない。予想外の列を誰も確認しなければ、ジョブが健康に見えるまま producer が取引の意味を変えてしまう。
発見方式、権限、費用をつなぐ
directory listing と notifications はファイルを異なる方法で見つける。listing は storage-read access から始められ、準備が少ない。小さな検証ディレクトリや一度限りの移行に使える。classic notifications はストリームごとの cloud event と queue resources を使う。managed file events は Unity Catalog external location を単位に discovery をまとめ、ストリームごとの resource 管理を減らす。通知を使っても業務イベントの順序が保証されるわけではない。
file events の設定資料 は Unity Catalog と、credential や external location を設定する権限を必要とする。cloudFiles.useManagedFileEvents=true は infrastructure を用意したあとにクエリへ渡す設定であり、cloud 権限を付与する命令ではない。classic の useNotifications と併用したり、classic の queue-tuning options を managed の構成へ持ち込んだりしない。
設計では人と identity を分ける。管理者は access と events を用意する。取り込み identity は許可された landing path を読み、状態を保存し、target に書く。BI identity は承認された table を読む。dashboard reader には checkpoint access も cloud queue の設定権限も不要である。具体的な cloud・Unity Catalog privileges を割り当てる前に、必要な操作を書き出す。この教材では権限 policy を検証していない。
managed events でも、初回 backfill や cache recovery では directory listing が起こりうる。公式資料は event cache の期限切れを避けるため、Auto Loader を少なくとも七日に一度起動するよう案内する。月に一度の job なら再発見の仕事を織り込む。実際の workload で storage API と compute の請求を評価する。この教材の費用説明は独立した benchmark ではない。
未実施の取り込みコード例
以下は 未実施。文書にある API を組み合わせた自作の JSON Bronze 設計で、default の listing を使う。notification configuration は作らない。実行する前に catalog、schema、volumes を作成して権限を与え、互換性のある compute を選び、test input directory にサンプルを入れ、例の path と table name を置き換える。本番の landing path を演習に使わない。
from pyspark.sql import functions as F

source = "/Volumes/training/ingestion/orders_landing/incoming"
state = "/Volumes/training/ingestion/orders_state/order_events_v1"
target = "training.bronze.order_events_raw"

raw = (
    spark.readStream.format("cloudFiles")
    .option("cloudFiles.format", "json")
    .option("cloudFiles.schemaLocation", f"{state}/schema")
    .option("cloudFiles.schemaEvolutionMode", "rescue")
    .option("rescuedDataColumn", "_rescued_data")
    .option("cloudFiles.schemaHints", "_corrupt_record STRING")
    .option("columnNameOfCorruptRecord", "_corrupt_record")
    .option("cloudFiles.includeExistingFiles", "true")
    .load(source)
    .select(
        "*",
        F.col("_metadata.file_path").alias("source_file"),
        F.col("_metadata.file_modification_time").alias("source_modified_at"),
    )
)

query = (
    raw.writeStream.format("delta")
    .option("checkpointLocation", f"{state}/checkpoint")
    .trigger(availableNow=True)
    .toTable(target)
)
query.awaitTermination()
既知の schema hint で parse-error column を保持しつつ、完全な明示 schema は渡していない。file・byte の手動調整は、選ぶ Runtime と測定する workload に依存するので入れていない。file provenance を残し、state を incoming files から分離する。Silver の検証、イベント重複排除、出力先の復旧、本番 schedule は実装していない。空の directory では明示 schema が必要になることもある。FAQ の説明どおり、推論を試す前に有効な sample input を用意する。
Bronze から Silver、BI へ:先に粒度を決める
medallion architecture はデータ品質の設計 pattern である。Bronze は入力の証拠を残し、Silver は詳細なレコードを検証し、Gold は業務向けの model や集計を整える。これは論理上の責務であり、必ず三つの物理 table にする決まりではない。
注文設計では dashboard を選ぶ前に、table の一行の意味を決める。
| データセット | 一行が表すもの | 保持する判断 |
|---|---|---|
| Bronze delivery rows | ファイル provenance と例外フィールドを伴う入力の一行 | どの配信が証拠を提供したか。繰り返し届いたイベントも調べられる。 |
| Silver event history | 受理した一つの event_id と合意した version |
どの有効な注文変化が、いつ起きたか。遅れて届く修正は明示した方針に従う。 |
| Silver order items | ある注文内の現在の一つの商品明細 | 現在の明細金額はいくらか。注文合計を全明細に繰り返さない。 |
| Gold daily sales | 一つの業務日・地域・通貨 | 定義上、どのイベントを売上へ含めるか。返金や time zone を明示する。 |
三つの明細を持つ注文で、join 後の table に注文合計 60 が各明細行へ繰り返されると、その列の合計は 180 になる。取り込み成功では、この modeling error を防げない。注文粒度の fact を別に持つか、明細粒度の金額を業務契約に従って集計する。通貨 code が違う金額は、日付を持つ換算方針なしに足せない。返金は当日の指標を変えるのか、元の販売日の数字を修正するのか。BI tile を作る前に決める。
別の Silver quarantine dataset には、変換に失敗した値、欠けた event identifier、未確認の schema drift と理由を残す。公開する指標には、鮮度と却下したレコード数も添える。鮮度には少なくとも、最後の source-event 時刻、最後の data processing 完了、最後の dashboard refresh という三つの時計がある。取り込みジョブの緑色は、その一部しか示さない。
止まった層を診断する
Auto Loader monitoring を、その層の証拠として使う。全体を一つの health score に縮めない。numFilesOutstanding と numBytesOutstanding は backlog を示す。cloud_files_state() は checkpoint に結びついた file state を調べる。timestamp columns は Runtime・configuration の条件があるので、timestamp がないことを未処理の証拠にはできない。
| 症状 | 最初に調べる証拠 | 自作の診断方針 |
|---|---|---|
| 届くはずのファイルがない | 正確な input path、権限、file filters、discovery state | compute を増やす前に、producer が配信を完了し、path が対象内か確かめる。 |
| 小さなファイルが溜まる | file/byte backlog と discovery duration | listing・admission overhead と parsing・writing を分ける。byte の変更だけでは個数制約を外せないかもしれない。 |
| schema 関連で再起動する | error、schema state、選んだ evolution mode | 文書にある追加列での再起動と、互換性のないデータや出力契約の変更を区別する。 |
| 取り込みは正常だが売上が誤る | Silver event IDs、join cardinality、通貨、指標定義 | 発見方式を疑う前に、一つの重複イベントを端から端まで追う。 |
| 復旧後に重複する | checkpoint の識別と保存状態、source paths、overwrite policy | 復旧完了とする前に、新ストリームの replay と出力済みの行を照合する。 |
最初の演習では cleanup を入れない。clean-source guide は速い consumer がファイルを消すと遅い consumer が読めなくなること、削除対象になる時点の現在の設定が使われることを警告する。入力の削除は下流へ影響する方針である。storage graph の数字を下げるためだけに有効化しない。
オフライン演習と、その後の検証計画
次の演習は 未実施 であり、account は不要。ローカルの台帳に十個の架空の file path、byte size、含まれる event ID を書く。新しい coupon field、壊れた JSON record、別の path で繰り返すイベント、遅れた修正を混ぜる。discovery、parser、Silver、Gold それぞれの期待結果を別々に記す。先ほどの admission 例で、ファイル個数と byte が違う batch を制約する理由を説明し、正確な処理順を主張しない。
さらに三つの判断を普通の言葉で書く。初回 backfill の境界。schema exception の担当者と解決方針。業務イベントの identity と correction rule。checkpoint を失うと何が残り、保存した Bronze や source evidence から何を作り直せるかも描く。復旧計画が「notebook を再実行する」だけなら、すでに書いた行の判断が抜けている。
後日、許可された sandbox で試すなら Runtime、cloud、compute、path layout、grants、option values を固定する。一度実行し、同じ checkpoint で再起動し、新しい不変ファイルを届け、さらに別 path の重複を届ける。各段階の file states と row counts を記録する。schema change を試し、quarantine と確認処理も確かめる。checkpoint loss を試す破壊的な演習には、隔離した state と target data が必要である。同じ workload で listing と準備済み events の費用や遅延を観測する。現時点では測定結果はない。
exporter が再送しても、ジョブ成功を売上の正しさと取り違えずに判断できる。Bronze は何が届いたかを保存し、Silver はどのイベントなのかを決め、BI model はそのイベントが何を指標へ加えるかを決める。
出典
公開日は資料の日付、確認日は内容を参照した日です。コミュニティの観測は公式の確定事項と区別します。
01